• Saltar al contenido principal
  • Skip to secondary menu
  • Saltar a la barra lateral principal
  • Saltar al pie de página
  • Inicio
  • Secciones
    • Ciencia de datos
    • Criptografía
    • Herramientas
    • Machine Learning
    • Noticias
    • Opinión
    • Productividad
    • Programación
      • JavaScript
      • Julia
      • Matlab
      • Python
      • R
  • Programación
    • JavaScript
    • Julia
    • Matlab
    • Python
    • R
  • Laboratorio
    • Estadística
      • Calculadora del Tamaño Muestral en Encuestas
      • Calculadora de estadísticos descriptivos
      • Test de normalidad
      • Calculadora de contrastes de hipotesis
      • Calculadora de tamano del efecto
      • Simulador de Regresión Lineal con Ruido
      • Visualizador de PCA
      • Visualizador de Series Temporales
      • Simulador de Regresión Logística
      • Simulador de K-Means
      • Simulador de DBSCAN
      • Detector de la Ley de Benford
      • Ajuste de Curvas
      • Calculadora de Matrices
    • Probabilidad
      • Calculadora de Probabilidad de Distribuciones
      • Calculadora de Probabilidades de Lotería
      • Simulador del Problema de Monty Hall
      • Simulador de la Estrategia Martingala
    • Finanzas
      • Calculadora de Préstamos e Hipotecas
      • Conversor TIN ↔ TAE
      • Calculadora DCA con ajuste por inflación
      • Calculadora XIRR con Flujos Irregulares
      • Simulador FIRE (Financial Independence, Retire Early)
    • Negocios
      • CLV
      • Scoring
    • Herramientas
      • Formateador / Minificador de JSON
      • Conversor CSV ↔ JSON
      • Comparador y Formateador de Texto y JSON
      • Formateador y Tester de Expresiones Regulares
      • Inspector de JWT
      • Generador y verificador de hashes
      • Codificador / Decodificador Base64 y URL
      • Conversor de bases numericas
      • Conversor de Timestamp Unix
      • Conversor de colores
      • Generador de UUIDs
    • Juegos
      • Tres en Raya
      • Nim con Q-Learning
    • Más
      • Método D’Hondt
      • Generador de Contraseñas Seguras
  • Noticias
  • Boletín
  • Contacto
  • Tienda
    • Libros
    • Equipamiento de oficina
    • Equipamiento en movilidad

Analytics Lane

Ciencia e ingeniería de datos aplicada

  • Ciencia de datos
  • Machine Learning
  • IA Generativa
  • Python
  • Pandas
  • NumPy
  • R
  • Excel

Migrar tslane a un paquete dual CommonJS y ESM con tsup y Vitest

octubre 1, 2026 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 5 minutos

tslane es la plantilla que uso como punto de partida para mis librerías TypeScript, nacida de la serie de 2020 y actualizada varias veces desde entonces. La más reciente, sobre consistencia de nombres con ESLint. En esta entrada aplico el razonamiento de la primera entrada de esta serie a este proyecto, pero con una diferencia clave respecto a la anterior: tslane no es una … [Leer más...] acerca de Migrar tslane a un paquete dual CommonJS y ESM con tsup y Vitest

Cómo construir tu primer scorecard paso a paso
septiembre 29, 2026 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 10 minutos

En los artículos anteriores de esta serie vimos la teoría detrás del credit scoring: qué son el WOE y el IV, cómo funciona el binning, cómo se transforma una regresión logística en un scorecard, qué diferencia la calibración de la discriminación y cómo monitorizar un modelo en producción. En este tutorial conectamos toda esa teoría con la práctica: construiremos un scorecard … [Leer más...] acerca de Cómo construir tu primer scorecard paso a paso

Actualizar expresslanets a ES Modules con tsx y Vitest

septiembre 24, 2026 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 4 minutos

expresslanets es la plantilla de API REST con Express y TypeScript que empezó como una serie de diez entradas en 2022 y que desde entonces ha ido incorporando mejoras, como la documentación con OpenAPI/Swagger. En esta entrada aplico el razonamiento de la entrada anterior de esta serie a este proyecto en concreto: paso la plantilla a ES Modules, sustituyo ts-node/Nodemon por … [Leer más...] acerca de Actualizar expresslanets a ES Modules con tsx y Vitest

Pareto/NBD: cuando el abandono silencioso cambia el CLV
septiembre 22, 2026 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 7 minutos

En el artículo del Dashboard vimos que Pareto/NBD aparecía junto a BG/NBD con un ajuste estadístico casi idéntico (log-verosimilitud -17.135,8 vs -17.138,2) pero un CLV medio bastante más bajo (15 € vs 29 €). Quedó pendiente explicar por qué. Este artículo cierra ese hueco: la diferencia entre ambos modelos no está en cómo se ajustan a los datos observados, sino en qué asumen … [Leer más...] acerca de Pareto/NBD: cuando el abandono silencioso cambia el CLV

Por qué migrar tus proyectos TypeScript a ES Modules en 2026

septiembre 17, 2026 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 5 minutos

Durante años, CommonJS (require/module.exports) ha sido la forma por defecto de organizar módulos en Node.js, y la inmensa mayoría de proyectos TypeScript (incluidos los publicados en Analytics Lane) se han construido sobre esa base sin cuestionarla demasiado. Pero el ecosistema lleva tiempo moviéndose en otra dirección, y creo que ha llegado el momento de explicar por qué he … [Leer más...] acerca de Por qué migrar tus proyectos TypeScript a ES Modules en 2026

Método del codo: interpretación correcta y limitaciones
septiembre 15, 2026 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 6 minutos

Cuando usas k-means tienes que decidir algo incómodo de entrada: cuántos grupos, , vas a buscar en el conjunto de datos. Y como el algoritmo no lo decide por ti, casi todo el mundo recurre al mismo truco: el método del codo. Dibujas una curva, buscas el "punto donde se dobla" y ese es tu número de clusters. Rápido, visual y aparentemente objetivo.El problema es que el … [Leer más...] acerca de Método del codo: interpretación correcta y limitaciones

Errores comunes al interpretar resultados estadísticos
septiembre 10, 2026 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 6 minutos

La estadística no suele fallar en los cálculos: falla en la interpretación. El test está bien hecho, el número es correcto… y aun así la conclusión que se saca de él es errónea. Estos malentendidos no son anécdotas de principiante; aparecen en artículos científicos, informes de empresa y, especialmente, titulares de prensa todos los días.En esta entrada reunimos los errores … [Leer más...] acerca de Errores comunes al interpretar resultados estadísticos

Dashboard CLV: cuatro modelos, un mismo dataset, conclusiones muy distintas
septiembre 8, 2026 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 7 minutos

Los artículos anteriores de esta serie cubrieron cuatro formas de mirar el valor del cliente: la fórmula clásica de retención, la segmentación RFM, y los modelos probabilísticos BG/NBD y BG/BB. Cada uno responde a una pregunta distinta y descansa en supuestos distintos. El Dashboard del laboratorio los ejecuta todos sobre el mismo conjunto de datos, lo que permite algo que … [Leer más...] acerca de Dashboard CLV: cuatro modelos, un mismo dataset, conclusiones muy distintas

Curiosidad: Por qué la criptografía habla siempre de Alice y Bob
septiembre 3, 2026 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 3 minutos

Quien se acerca a la criptografía descubre enseguida a dos personajes que aparecen en casi todos los manuales, artículos y exámenes: Alice y Bob. Alice quiere enviarle un mensaje a Bob de forma segura, Bob tiene una clave, alguien intenta espiarlos por el camino… La escena se repite hasta el infinito. Pero ¿por qué precisamente esos nombres? ¿Es solo que A va antes que B en el … [Leer más...] acerca de Curiosidad: Por qué la criptografía habla siempre de Alice y Bob

Desbalanceo de Clases en Credit Scoring: Por Qué Usamos Ponderación en lugar de Undersampling
septiembre 1, 2026 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 9 minutos

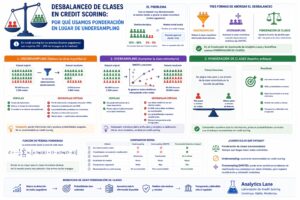
En credit scoring el desbalanceo de clases es la norma, no la excepción. En una cartera de crédito al consumo típica la tasa de default oscila entre el 2% y el 15%. Eso significa que por cada cliente que impaga hay entre 6 y 50 que pagan correctamente. El dataset de entrenamiento refleja esa realidad y esa asimetría plantea un problema técnico concreto al ajustar el … [Leer más...] acerca de Desbalanceo de Clases en Credit Scoring: Por Qué Usamos Ponderación en lugar de Undersampling

Curiosidad: El “bug”, la polilla y la leyenda de Grace Hopper
agosto 27, 2026 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 4 minutos

Cualquiera que programe usa la palabra bug a diario para referirse a un fallo en el código. Y casi todos hemos oído la bonita historia de que el término nació cuando una polilla quedó atrapada en un ordenador y alguien la pegó en un cuaderno. Pero ¿es verdad esa historia? ¿La descubrió realmente Grace Hopper? ¿Y fue de verdad el "primer bug" de la informática? La respuesta a … [Leer más...] acerca de Curiosidad: El “bug”, la polilla y la leyenda de Grace Hopper

BG/BB: el modelo de CLV para compras en períodos discretos
agosto 25, 2026 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 9 minutos

Los dos artículos anteriores de la serie cubrieron BG/NBD, el modelo para negocios donde el cliente puede comprar en cualquier momento con frecuencia libre. Pero no todos los negocios funcionan así. Hay un grupo amplio de contextos (donaciones a campañas periódicas, renovaciones de membresía, compras de catálogo estacional) donde el cliente no decide "cuándo" comprar, sino "si … [Leer más...] acerca de BG/BB: el modelo de CLV para compras en períodos discretos

  • Página 1
  • Página 2
  • Página 3
  • Páginas intermedias omitidas …
  • Página 105
  • Ir a la página siguiente »

Barra lateral principal

Suscríbete a nuestro boletín

Suscríbete al boletín semanal para estar al día de todas las publicaciones.

Política de Privacidad

Analytics Lane en redes sociales

  • Amazon
  • Bluesky
  • Facebook
  • GitHub
  • Instagram
  • Mastodon
  • Pinterest
  • RSS
  • Telegram
  • Tumblr
  • Twitter
  • YouTube

Publicidad

Entradas recientes

Migrar tslane a un paquete dual CommonJS y ESM con tsup y Vitest

octubre 1, 2026 Por Daniel Rodríguez

Cómo construir tu primer scorecard paso a paso

septiembre 29, 2026 Por Daniel Rodríguez

Actualizar expresslanets a ES Modules con tsx y Vitest

septiembre 24, 2026 Por Daniel Rodríguez

Publicidad

Es tendencia

  • Creación de gráficos de barras y gráficos de columnas con Seaborn publicado el julio 18, 2023 | en Python
  • Noticias Disponible la traducción de la tercera edicción de “Hands-On Machine Learning” de Aurelien Geron publicado el junio 20, 2023 | en Noticias
  • Cómo comparar tendencias con gráficos de líneas en Matplotlib: guía práctica paso a paso publicado el junio 9, 2026 | en Python
  • Cómo comparar datos con barras en Matplotlib: agrupadas, apiladas y porcentuales publicado el mayo 12, 2026 | en Python
  • El método de Muller e implementación en Python publicado el marzo 24, 2023 | en Ciencia de datos

Publicidad

Lo mejor valorado

4.9 (24)

Seleccionar filas y columnas en Pandas con iloc y loc

4.6 (16)

Archivos JSON con Python: lectura y escritura

4.4 (14)

Ordenación de diccionarios en Python mediante clave o valor

4.7 (13)

Operaciones de filtrado de DataFrame con Pandas en base a los valores de las columnas

4.1 (11)

Aplicar el método D’Hondt en Excel

Comentarios recientes

  • Daniel Rodríguez en Curiosidad: La Paradoja de Simpson, o por qué no siempre debes fiarte de los promedios
  • Hatepi en Curiosidad: La Paradoja de Simpson, o por qué no siempre debes fiarte de los promedios
  • Daniel Rodríguez en Los récords con asterisco, o la épica del titular sin contexto – El bestiario de los indicadores económicos absurdos (parte 8 y final)
  • Juan en Los récords con asterisco, o la épica del titular sin contexto – El bestiario de los indicadores económicos absurdos (parte 8 y final)
  • bif en JSON en bases de datos: cuándo es buena idea y cuándo no

Publicidad


Footer

Analytics Lane

  • Acerca de Analytics Lane
  • Boletín de noticias
  • Contacto
  • Libros
  • Lo más popular
  • Noticias
  • Tienda
  • Tiendas afiliadas

Secciones

  • Ciencia de datos
  • Criptografía
  • Herramientas
  • Machine Learning
  • Opinión
  • Productividad
  • Programación
  • Reseñas

Sobre de Analytics Lane

En Analytics Lane tratamos de explicar los principales conceptos de la ciencia e ingeniería de datos con un enfoque práctico. Los principales temas tratados son ciencia de datos, ingeniería de datos, inteligencia artificial, machine learning, deep learning y criptografía. Además, también se habla de los principales lenguajes de programación y herramientas utilizadas por los científicos e ingenieros de datos.

Copyright © 2018-2026 Analytics Lane ·Términos y condiciones ·Política de Cookies ·Política de Privacidad ·Herramientas de privacidad ·Contacto